Obsidian VaultにVector DBを入れる前に、Markdownの構造だけでReasoning Indexを作ってみた
Obsidian VaultのMOC・Properties・見出し・内部リンクを再利用し、Vector DBやEmbeddingなしでAI向け階層索引を作る設計と実装を整理します。
Obsidian VaultにVector DBを入れる前に、Markdownの構造だけでReasoning Indexを作ってみた
RAGを作ろうとすると、Vector DB、Embedding、Chunkingという言葉がかなり早い段階で出てきます。
もちろん、それらが必要なケースはあります。
ただ、私が使っているObsidian Vaultを見ていて、ひとつ疑問がありました。
このMarkdown群、本当に最初から「意味のない文章の塊」なのだろうか。
実際には、すでにフォルダがあります。索引があります。Propertiesがあります。内部リンクがあります。そして各ノートには #、##、### で見出し構造があります。
つまり、人間が読むための構造はすでにかなり入っています。
そこで今回は、Vector DBやEmbeddingを追加する前に、 既存のMarkdown構造だけを使ってAI向けの階層索引を作る ことにしました。
私の実装ではこれを Reasoning Index と呼んでいます。これはPageIndexの公式用語ではなく、この記事で作った仕組みを説明するための名前です。
きっかけはPageIndexだった
発想のきっかけになったのは、VectifyAIのOSS PageIndex です。
PageIndexは公式READMEで、Vector DBやChunkingを前提にせず、文書へ階層的なTree Indexを作り、LLMがその木を辿って関連箇所を探す方式を説明しています。
ざっくり言えば、
質問
  ↓
文書全体の目次を見る
  ↓
関係ありそうな章を選ぶ
  ↓
その下の節を見る
  ↓
必要な本文へ到達する
という、人間が長い資料を読むときに近い探索です。
PageIndexの公開実装にはMarkdown入力もあり、CLIの --md_path からMarkdownを受け取り、parser側では # 〜 ###### の見出しレベルを使ってTreeを構築しています。
- PageIndex: https://github.com/VectifyAI/PageIndex
- Markdown CLI: https://github.com/VectifyAI/PageIndex/blob/main/run_pageindex.py
- Markdown tree parser: https://github.com/VectifyAI/PageIndex/blob/main/pageindex/page_index_md.py
ここで私が面白いと思ったのは、「PageIndexをそのまま導入しよう」ではありませんでした。
ObsidianのMarkdownは、そもそもTree Indexを作りやすいのではないか。
という点です。
Obsidian Vaultには、すでに検索の手掛かりがある
私のVaultでは、ノート本文以外にも複数の構造を使っています。
- フォルダ
- 分野別の索引ノート
- YAML Properties
- Markdown見出し
- Markdown内部リンク
ObsidianのPropertiesはMarkdownファイルの先頭に構造化メタデータを持てます。また、ノート同士は内部リンクで関係付けられます。
もちろん、これだけでSemantic Searchと同じことができるわけではありません。
ただし「まずどのノートを見るべきか」「そのノートのどの章を見るべきか」を絞る材料としては十分使えます。
そこで、全文を細切れにしてEmbeddingする代わりに、次の順序で探索できる索引を作りました。
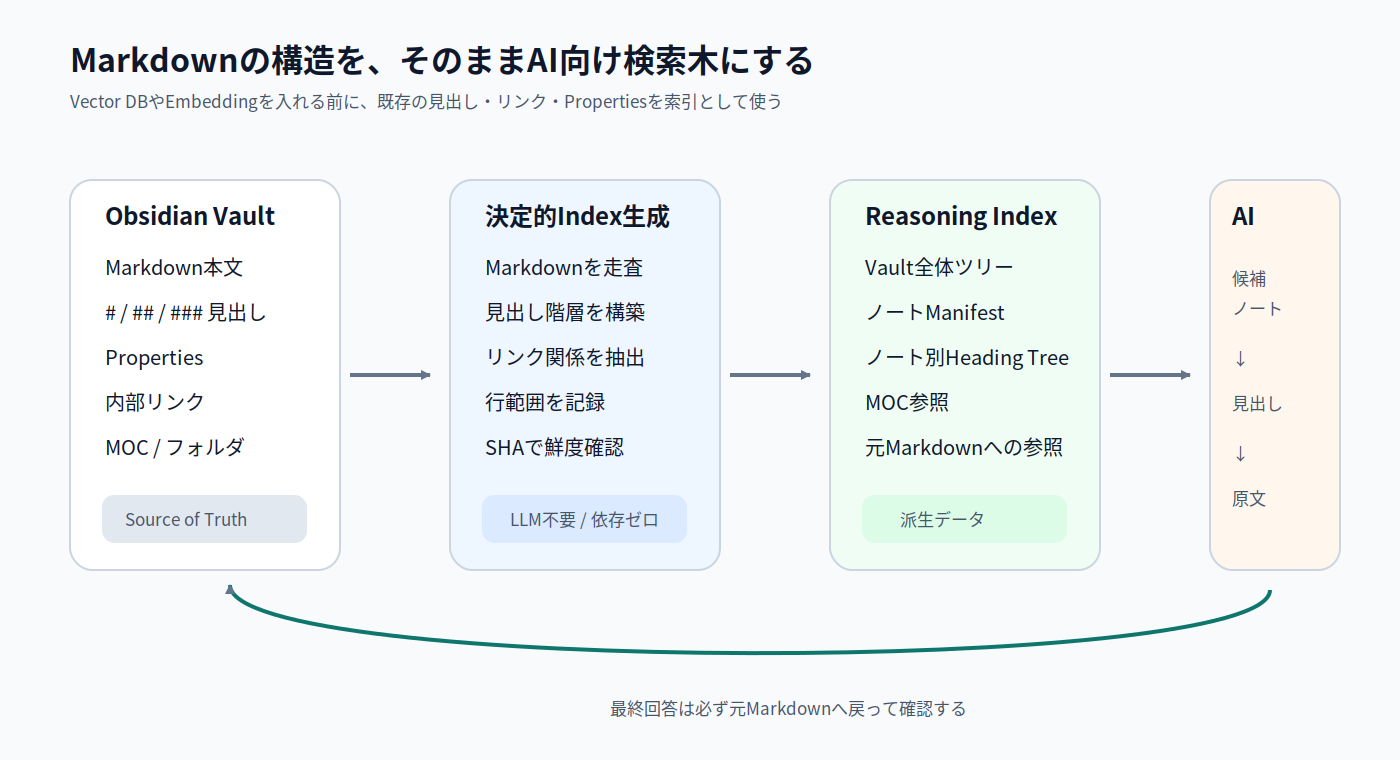
重要なのは、一番右まで進んでも 索引を正本にしない ことです。
AIが候補を絞ったら、最後は必ず元のMarkdownへ戻ります。
v1では、索引生成にLLMを使わなかった
今回のv1で優先したのは検索性能の最大化ではなく、まず次の条件を満たすことでした。
- 元MarkdownをSource of Truthとして維持する
- 外部サービスへVault本文を送らない
- 同じ入力から同じ索引を作れる
- Vector DBを運用しない
- 追加依存をなるべく増やさない
- GitHub上で自動更新できる
そのため、索引生成はPython標準ライブラリだけで作りました。
LLMによる要約もEmbeddingもありません。
Markdownを機械的に読み、構造だけを抽出します。
1. Markdownを走査する
まずVault内の .md を列挙します。
生成済みIndexやObsidian自身の設定ディレクトリなど、検索対象にしない領域は除外します。
2. Propertiesを読む
全文をYAMLデータベース化するのではなく、検索に使う最小限の項目だけ取得します。
例えば、
type: resource
status: active
tags:
  - ai
  - github
のような属性です。
3. 見出しをTreeにする
Markdownの見出しを、親子関係へ変換します。
# GitHub Actions

## 自動生成物

### staleな実行を上書きしない

## デバッグ
なら、索引側では概念的にこうなります。
GitHub Actions
├─ 自動生成物
│  └─ staleな実行を上書きしない
└─ デバッグ
コードブロック内に書かれた # は見出しとして扱わないようにします。
さらに各見出しについて、元Markdownの開始行と終了行も記録します。
これでAIは「ノート全体を読んで」ではなく、 この見出しのこの範囲を読んで と絞れます。
4. 内部リンクと索引ノートの参照を取る
Markdownリンクも抽出します。
特に分野別の索引ノートからリンクされているノートは、どの分野から辿れるかを記録します。
これにより、ファイル名だけでなく、
技術
  ↓
GitHub / CI
  ↓
対象ノート
のような上位構造を持てます。
5. 元ノートのhashを持つ
派生Indexが古くなっている可能性もあります。
そこで元MarkdownのSHA-256をManifest側へ保存します。
索引を生成した時点の本文と、現在の本文が一致するかを確認できるようにしました。
生成物は3層に分けた
v1のIndexは大きく3種類です。
Vault全体のTree
フォルダとノートの位置関係を見る軽量なTreeです。
{
  "kind": "folder",
  "name": "technology",
  "children": [
    {
      "kind": "note",
      "title": "GitHub Actions",
      "heading_count": 8
    }
  ]
}
ノートManifest
全ノートについて、検索時に先に見たい情報を一覧にします。
{
  "path": "...",
  "title": "GitHub Actions",
  "type": "resource",
  "status": "active",
  "top_headings": [
    "GitHub Actions"
  ],
  "sha256": "..."
}
ここでは path は説明用に省略しています。実装では元Markdownを一意に参照できる値を持たせます。
ノート別のHeading Tree
候補ノートが決まった後に読む詳細Indexです。
{
  "title": "自動生成物",
  "line": 42,
  "end_line": 78,
  "children": [
    {
      "title": "staleな実行を上書きしない",
      "line": 51,
      "end_line": 63
    }
  ]
}
この3層を分けることで、最初から全ノートの全見出しをContextへ入れずに済みます。
AI側のルールも変えた
Indexを作るだけでは、AIが使ってくれるとは限りません。
そこでAI側の検索順も決めました。
対象ノートが分からない質問では、
1. Vault全体Tree / Manifestを見る
2. 候補ノートを絞る
3. ノート別Heading Treeを見る
4. 読む見出しと行範囲を絞る
5. 元Markdownを読む
6. 元Markdownを根拠に回答する
とします。
逆に、最初から対象ファイルが明確ならIndexを儀式的に通りません。
直接Markdownを読んだ方が早いからです。
また、Indexが壊れていたり古かったり、候補を十分に絞れない場合は通常のRepository検索へ戻ります。
Indexを必須経路にするのではなく、安い絞り込み経路として使う という位置付けです。
GitHub Actionsで自動更新する
Obsidian Vaultは日々変わります。
索引を手動生成にすると、ほぼ確実に古くなります。
そのためMarkdownが更新されたら、GitHub Actionsで次を実行するようにしました。
Markdown変更
  ↓
unit test
  ↓
Reasoning Index生成
  ↓
JSON検証
  ↓
差分がある場合だけ生成物をcommit
もう一つ入れたのが、並行更新への対策です。
Workflow実行中にmain側が先へ進んでいた場合、古いcheckoutから作ったIndexをそのままpushしません。
新しいrevision側のrunに再生成を任せます。
個人Vaultでも、AI、手動編集、自動処理が同時にGitHubへ触るようになると、この手の競合は普通に起こり得ます。
実Vaultでは約180ノートをIndex化した
今回の実装を、自分のObsidian Vault全体へ適用しました。
対象になったMarkdownは 約180ノート です。
各ノートについて、
- Properties
- 見出しTree
- 行範囲
- 内部リンク
- 上位索引からの参照
- 元本文のhash
を生成できるところまで確認しました。
ここで重要なのは、「約180ノートだからVector DBはいらない」と一般化することではありません。
今回確認できたのは、 少なくともこの規模・この構造のVaultでは、最初の検索層をVector DBにしなくても成立する余地がかなりあった ということです。
これはPageIndexの再実装ではない
ここは明確に分けておきます。
PageIndexは、Tree Indexを使ってLLMがreasoning-based retrievalを行う仕組みです。現在の公式実装にはローカルモードや複数文書を扱う仕組みもあります。
一方、今回のv1はもっと小さいです。
- Index生成は決定的なparser
- LLMによるIndex要約なし
- Vector検索なし
- Semantic Rankingなし
- 外部Cloudなし
- Query時の探索はAI側のルールで行う
つまり、PageIndexそのものを移植したのではなく、 「文書の構造を先に見て、必要箇所へ降りる」という発想をObsidianへ持ち込んだ ものです。
PageIndex公式が公開しているFinanceBenchの98.7%という結果も、今回のVault実装の精度を保証するものではありません。対象文書、評価問題、retrieval方式が違うためです。
Vector DBの方が向く場面も普通にある
今回の方式には分かりやすい弱点があります。
Markdownに良い構造が存在することへ依存します。
例えば、
- 見出しがほとんどない巨大ノート
- 内容とタイトルが一致していないノート
- 同じ概念が別名で大量に記録されている
- 文章の意味的な近さから横断検索したい
- 数万、数十万文書から候補を高速に絞りたい
といった条件では、EmbeddingやVector Searchの価値が上がります。
逆に、
- Markdownが正本
- 見出しをある程度きちんと書いている
- フォルダやMOCで分野を分けている
- Propertiesやリンクを使っている
- AIが最終的に原文へ戻れる
というVaultなら、まず構造を使ってみる価値があります。
将来的には、Treeで粗く候補を絞ったあと、必要な層だけSemantic Searchを使うHybridも考えられます。
最初から全部をEmbeddingするか、全部Treeで解決するかの二択ではありません。
RAGを作る前に「すでにある構造」を見る
今回PageIndexを見て一番参考になったのは、「Vector DBを使わない」という部分そのものではありませんでした。
検索対象を、最初から意味のないChunkの集合として扱わなくてもいい。
という点です。
Obsidian Vaultには、人間が長期間使う中で作った分類や見出しがあります。
それを全部捨ててからEmbeddingで構造を作り直す前に、まず既存構造をAIへ渡せる形へ変換する。
私のVaultでは、その最小実装だけで、
Vault
  ↓
候補ノート
  ↓
候補見出し
  ↓
元Markdown
という検索経路を作れました。
Vector DBを入れるかどうかは、その後でも遅くありません。
まず確認したいのは、 自分のデータは本当に「構造のないテキスト」なのか です。
参考資料
- VectifyAI / PageIndex
https://github.com/VectifyAI/PageIndex - PageIndex Markdown CLI
https://github.com/VectifyAI/PageIndex/blob/main/run_pageindex.py - PageIndex Markdown Tree Parser
https://github.com/VectifyAI/PageIndex/blob/main/pageindex/page_index_md.py - Obsidian Help — Internal links
https://help.obsidian.md/Linking+notes+and+files/Internal+links - Obsidian Help — Properties
https://help.obsidian.md/Editing+and+formatting/Properties